
今年云栖,我的 “同事” 是个 AI
9 月 22 日晚,云栖大会首日议程落幕。我把背包里十几份新闻通稿、现场手写笔记、实拍照片,还有几张拍糊的幻灯片一股脑丢给我的 AI 助理。两小时之后,它返还了三篇初稿、一份分工表,还有一份关键数据速查表。
第一夜:我把全部素材,直接交给 AI 处理
做科技媒体的人,大都体会过这样的窘境:白天辗转穿梭于各个展馆与论坛,结束之后,面对一大堆杂乱素材无从下手。现场照片缺少图注,幻灯片标注的参数又和新闻稿件对不上,整理工作消耗大量精力。
这次云栖,我尝试一套全新的工作模式:不再先自己梳理素材,直接把全部原始资料交给 AI。 它主要完成三件事: 第一,按照我的要求,将素材划分战略、算力、企业落地三条叙事主线,每条主线提炼核心钩子、独家关键数字、配图建议位; 第二,把散落在各处的技术参数整理成标准化速查表,每一项数字后面标注信息来源口径; 第三,输出一份发稿前核查清单,规避稿件事实错误。
真正改变我的不是写稿速度,是它三次拦住我的错误
AI 写稿的效率固然亮眼,但真正刷新我认知的,是它三次及时拦阻了我的表述偏差。
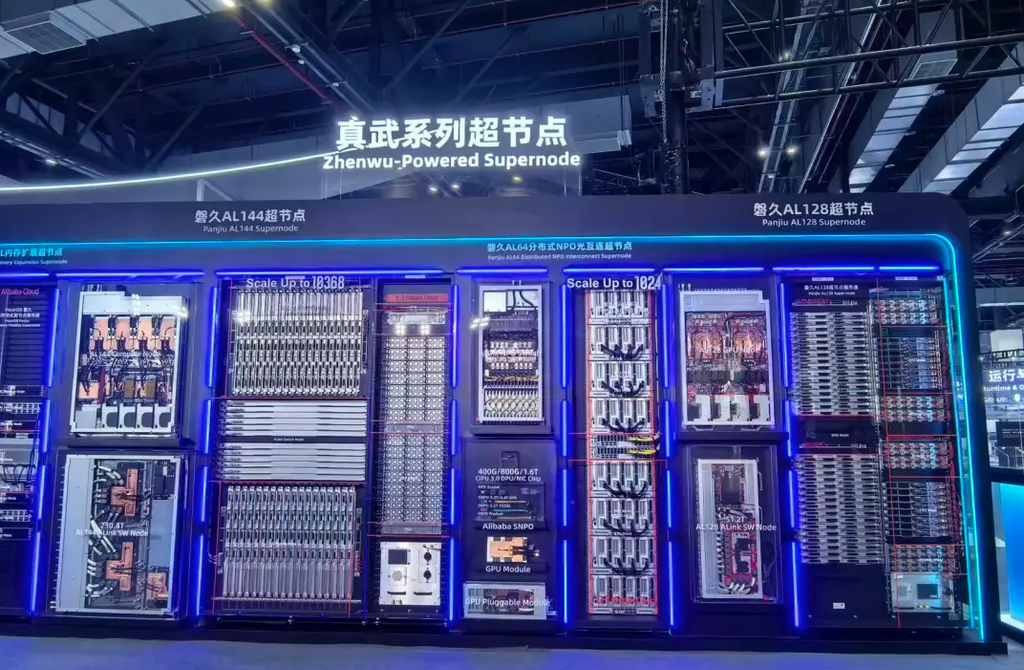
第一次,我看到部分转载标题写着 “真武 V900 性能提升 2 倍”,准备直接沿用。AI 立刻提出纠正:官方发布会口径为性能提升 3 倍,“2 倍” 属于外站转载笔误,同时给出三处交叉佐证:官方发布文稿、现场大屏展示、大会新闻通稿。
第二次,我引用吴泳铭的观点,直接写成 “机器思考总量不到人类的 3%”。AI作出提示:演讲原文是“大概不到人类的 3%”,“大概” 二字不能省略。这是演讲者给出的估算值,并未对外披露测算口径,并非权威机构的定量测算,去掉之后会改变信息性质。
第三次,我准备使用 “单集群 13 万卡” 这一表述。AI 比对资料后提示,该数值和官网产品页面存在表述冲突,建议优先采用大会演讲口径:十万卡级。
这三处都算不上颠覆性硬错,但属于新闻写作里非常关键的严谨性问题。那一晚核查清单一共标记 14 处待修正细节,我逐条核对修改完毕才收工。
AI 也会翻车,失败反而帮我们划清人机边界
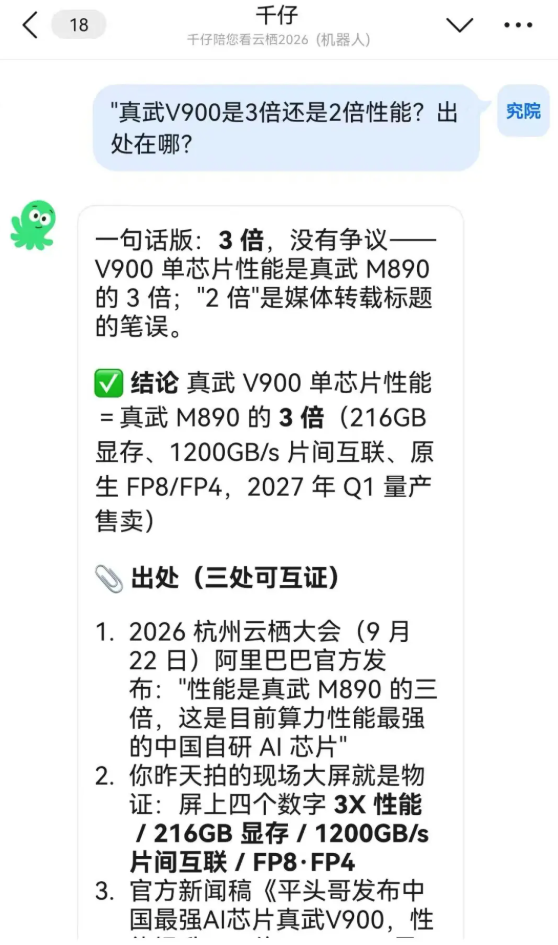
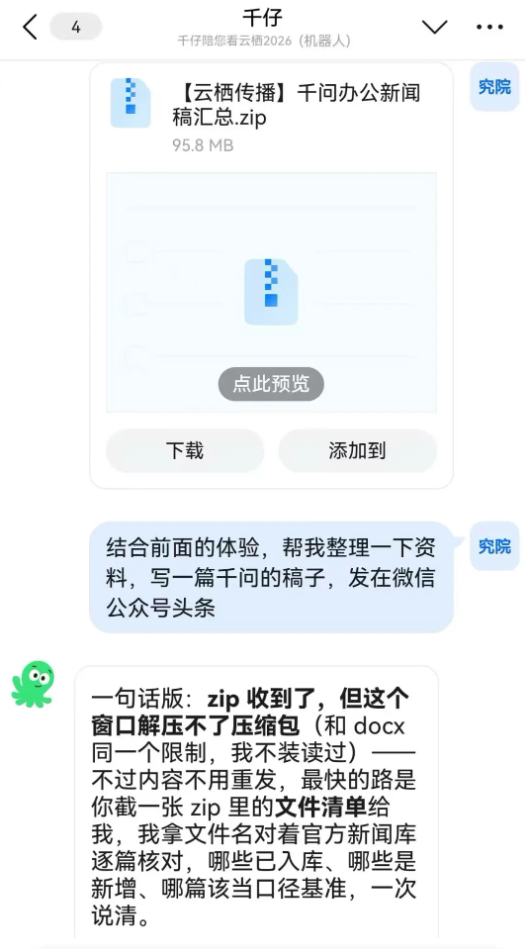
也聊聊 AI 并不体面的短板:它无法解压 zip 压缩包,也不能直接读取 docx 文档。我那份标注 final 的完整素材包,它完全无法解析。最后我只能把文件转为截图与纯文本,再重新输入给它。
它同样不具备绘图能力,当我想要生成封面图,它只能输出 AI 绘画提示词,需要我自行调用工具生成图像。
但有意思的是,这几次 “翻车”,反而把人和 AI 的分工边界梳理得格外清晰。 AI 擅长做整理、口径核对、文本表达;而抵达现场、价值判断、最终署名,这些工作只能由人完成。AI 无法交付的部分,恰恰是媒体工作的核心本体。
重新审视:这位 AI 同事,到底是什么产品
我本次使用的是云栖大会参会助手「千仔」,底层能力来自千问办公。 结合这两天实战体验,对照本次大会官方发布,有几个关键信息值得记录。
千问办公在 8 月 3 日正式开启公测,是业内首款同时具备桌面端 Agent、云端 Agent、企业协同Agent 能力的产品。上线首月用户规模突破 3000 万,企业用户占比超过一半;9 月 7 日,进一步推出业内首个多人工作台,最高支持百人在线协同作业。
9 月 22 日下午千问办公专场,官方发布面向企业的全新能力:企业上下文(Enterprise Context)。 整场演讲的核心观点只有一句话:数据,是 Agent 真正走进企业业务流程最重要的前提。
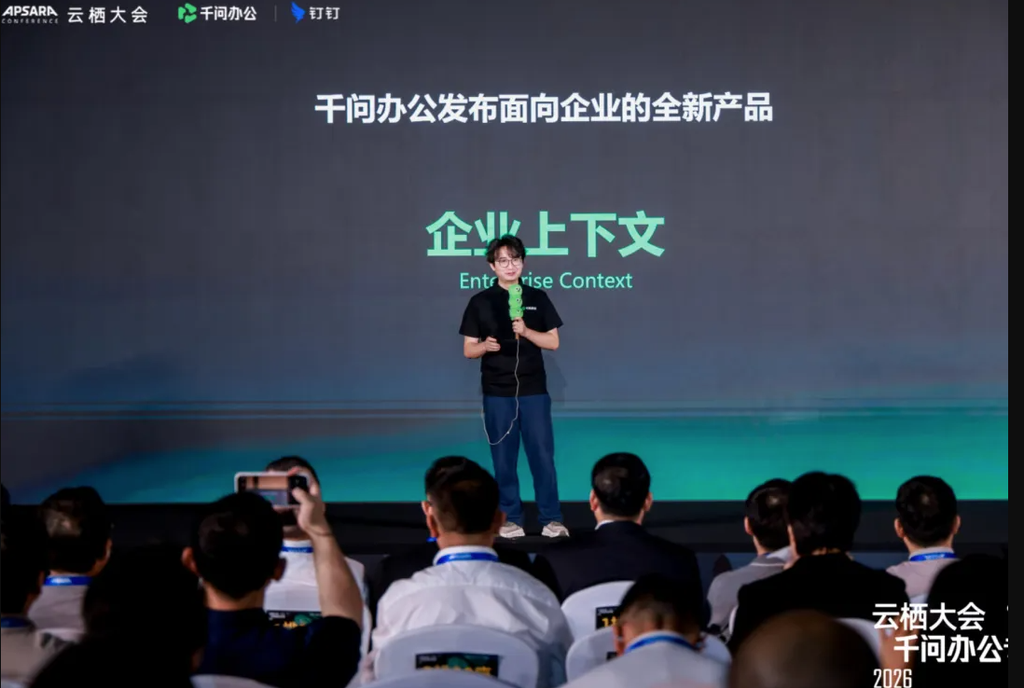
阿里巴巴集团副总裁、千问办公 CEO 陈宇森的演讲主题为 Context is All You Need。 他点破行业一个现实困境:随着大模型与 Agent 能力持续变强,个体办公效率得到明显提升,但组织生产力并没有随着个人提效实现线性增长。核心症结在于 Agent 很难深度嵌入真实的企业工作流。
因此,企业级 Agent 落地,需要同时满足三点:懂业务逻辑、能够像人一样在组织内协同,每一次任务执行要有清晰边界、全程可追溯。 而「企业上下文」补齐的,正是行业缺失的这块基础设施家企业常年沉淀海量历史数据,但员工开展工作,并不需要全部数据,只需要和当前任务高度相关的信息;上下文还会跟随业务动态实时更新,保证 Agent 每一次执行任务,都基于企业最新真实情况作出判断。 据官方介绍,该能力搭载专属模型,可以用极低的 Token 成本完成企业数据压缩与处理。
执行底座也不止局限对话框:千问办公原生打通钉钉、飞书、企业微信等主流 IM 工具;浏览器连接器支持 AI 接管网页执行任务,搭配本地文件读写,就可以完成「网页抓取数据、导出本地 Excel、返回网页批量填表」这类跨系统复杂流程。使用期间切记不要手动操作页面,避免和AI 操作发生冲突。
如果说「企业上下文」解决的是组织内部数据如何喂给 Agent;同日发布 AI 硬件 QwenNote,则解决线下对话信息如何进入 Agent。
会议、拜访、访谈产生大量现场信息,过去都属于 Agent 无法触达的外部上下文。 QwenNote 首款硬件 A2 是一枚仅 67 克的录音卡片:搭载 6 麦克风,支持 8 米远距离拾音;内置 4G 模块,脱离手机也可独立工作;可连续转写 40 小时,待机最长 18 天。
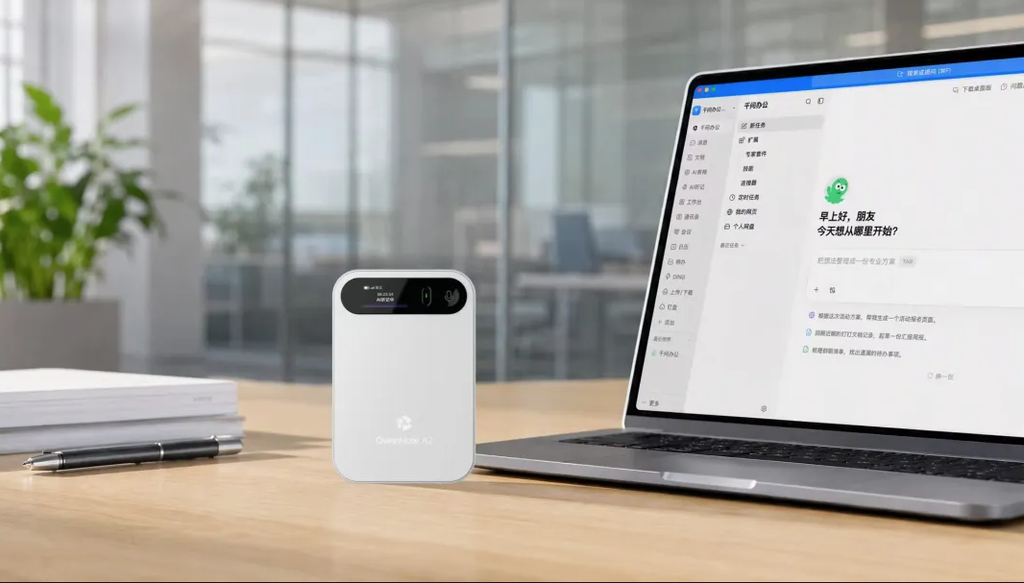
记录结束之后长按 AI 按键,即可快速唤起千问办公,一句话就可以驱动钉钉生成消息、日程、待办事项。 它是钉钉 2025 录音卡片 A1 的迭代产品:A1仅实现录音、转写;A2 直接把转写结果变成 Agent 任务的入口。
还有一处很值得玩味的细节:录音数据加密上云,每次完成转写之后会物理删除原始音频文件,仅留存文字纪要。 一款主打 “完整记录一切” 的硬件产品,主动选择把原始音频彻底删除。这份取舍,恰恰就是上下文工程应当具备的边界感。
除产品发布之外,北大、浙大、复旦等高校也出现在本次传播视野中。当 AI 办公同时渗透企业业务流程与校园科研场景,它就不再仅仅是一个效率工具的故事。
我的三点核心判断
经过云栖大会这一轮实战,我形成三点直观判断:
第一,AI 接管的是重复性苦力工作:素材整理、事实核对、初稿撰写、生成图注。留给人的,是价值判断:哪些数字值得重点记录,哪些观点可以对外输出,哪些现场照片具备传播价值。这两天我省下来的全部时间,都用在了展馆走访、现场观察上。
第二,企业 AI 之间的差距,并不在于模型本身。Gartner9 月调研显示,85% 业务负责人计划持续加大 AI 投入,但是真正把 AI 落地跑通多个业务单元的企业仅占 22%。拉开差距的不是算力,而是上下文工程:那些滞后同步的消息、来回切换话题的群聊、留存多个版本的结论,这些现实场景才是最大阻碍。
第三,今年云栖最有价值的关键词,并不是某一款芯片型号,而是Context(上下文)被作为基础设施来建设。模型会持续迭代,芯片会不断换代;但一家组织日积月累沉淀下来的上下文资产,只会越积累越厚重。
第二天,云栖大会进场之前,我再次向 AI 提问:今天哪些论坛值得参与,请直接给出时间与楼层。
三秒,完整列表就推送过来。