
50 万卡、5-10T、20GW:云栖第一天所有硬数字我都抄下来了
我把主论坛和各场发布里出现的硬数字都抄了下来:50 万卡、5-10T、20GW、216GB、1200GB/s、69%、33 轮……都在这篇里,速查表在文末。但如果只带一个数字回家,我建议是 42%。后面会解释为什么。
01 大概不到 3%
阿里巴巴集团CEO吴泳铭在云栖大会主论坛给出了两个数字:未来机器思考总量将是人类的 1000 倍以上,而“今天,机器思考的总量,大概不到人类的 3%”。
大概不到3%。这是他的估算,不是机构测算,口径未公布;1000 除3%约等于三万倍,所以他说“至少还有几万倍的增长空间”。
但这恰恰是这句话最有力的地方——它不是在描绘遥远的科幻,而是在承认我们才刚起跑。
他接着讲了电:1882 年爱迪生的珍珠街电站点亮了约 400 盏灯:1900年前后电器已进入家庭,但当时全世界一整年的发电量,放到今天只够用两个小时。今天的 AI Coding 就像当年的电灯。“无论后来出现多少新发明,第一步都要建足够多的发电站、铺足够广的电网。”
三块基石由此而来:AI 模型、AI 芯片、AI 云。
02 模型:把 Scaling 这条路继续走下去
过去一年,业界对通往 ASI 的技术路径逐渐形成共识,这条路径叫递归式自我改进(RSI):模型从真实反馈中发现自身短板,自主设计实验、构建数据、评价结果,循环推动自身进化。
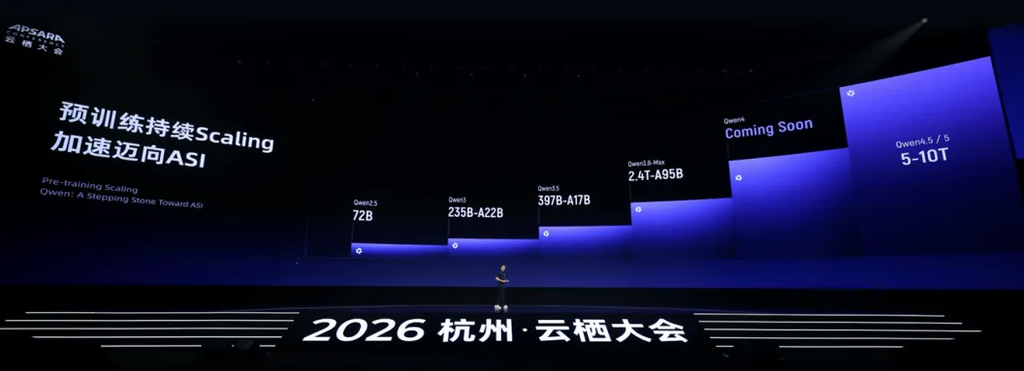
主论坛上,Qwen LLM项目负责人刘大一恒把它讲得更具体:Scaling 仍是迈向 ASI 的关键路径。基于新一代架构的 Qwen4 已投入训练,Qwen4.5、Qwen5 等后续版本的参数规模计划扩展至 5 万亿到 10 万亿。
注意”计划”两个字。这不是产品发布,是路线图。
作为铺垫,Qwen3.8-Flash 已经提前开源了下一代模型架构,通过注意力与模型内信息传递机制的创新,把训练成本压低约 90%,仅6B小参数模型即可达到前沿性能。
RSI 这块给了过程数据,我觉得比结论更有意思:Qwen3.8-Max 自主搭建训练流程、构造训练数据、自主设计实验、定位缺陷,在人类完全”零参与”的情况下持续迭代超过 1 个月,完成 33 轮有效迭代。基于RSI 与后训练的联合优化,新版本在 Artificial Analysis 基准上得分提升 12.5%
模型家族也在向两端延伸。
一端是多模态。吴泳铭的说法是”一颗聪明的大脑还不够”,AI 还得掌握感知和交互能力,像人一样理解声音、图像、表情和动作。所以 Qwen3.8-Omni 把视频、音频、图片、文字纳入统一理解框架,下一代视频生成模型将于11月发布;同声传译模型 Qwen3.8-LiveTranslate 把人类同传平均 4 秒以上的时延压到 2.5 秒以内。
另一端是终端。桌面端开源的 Qwen3.8-27B 可本地流畅运行,移动端推出 AI 手机全栈解决方案 Qwen Intelligence。
生态数据:已开源460 余个Qwen 模型,累计下载突破30亿次,衍生模型超30万个。
03 芯片与云:从”能不能用”到”可投入生产”
吴泳铭有句话很直白:如果说 Token 是 AI 时代的电,芯片就是发电机。未来机器智能时代对 Token 的需求几乎没有上限,芯片要不断提高性能、扩大供给。
今天的主角是真武 V900。
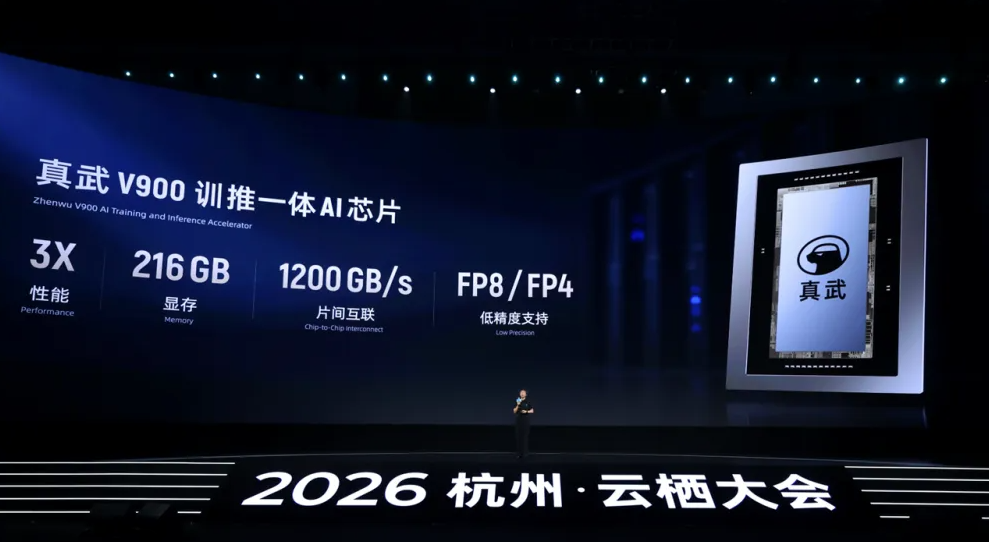
单芯片性能是真武 M890 的3倍,搭载216GB 显存,片间互联带宽1200GB/s,原生支持 FP8/FP4,计划 2027 年第一季度量产上市。通过自研 ICN Switch,可实现千卡全带宽高速互联。
再往上是系统。新一代磐久超节点服务器集成 V900、ICN Switch、磐脉智能网卡与镇岳 SSD 主控芯片,实现算存网全栈协同,单一 AI 集群可扩展至 50 万卡。明年推出的灵骏真武 V900 超节点会搭载业界首发 200Pbps 通信带宽、6μs 时延的集群架构,自研 SNPO 支持全光互联与千卡 Scale-Up。
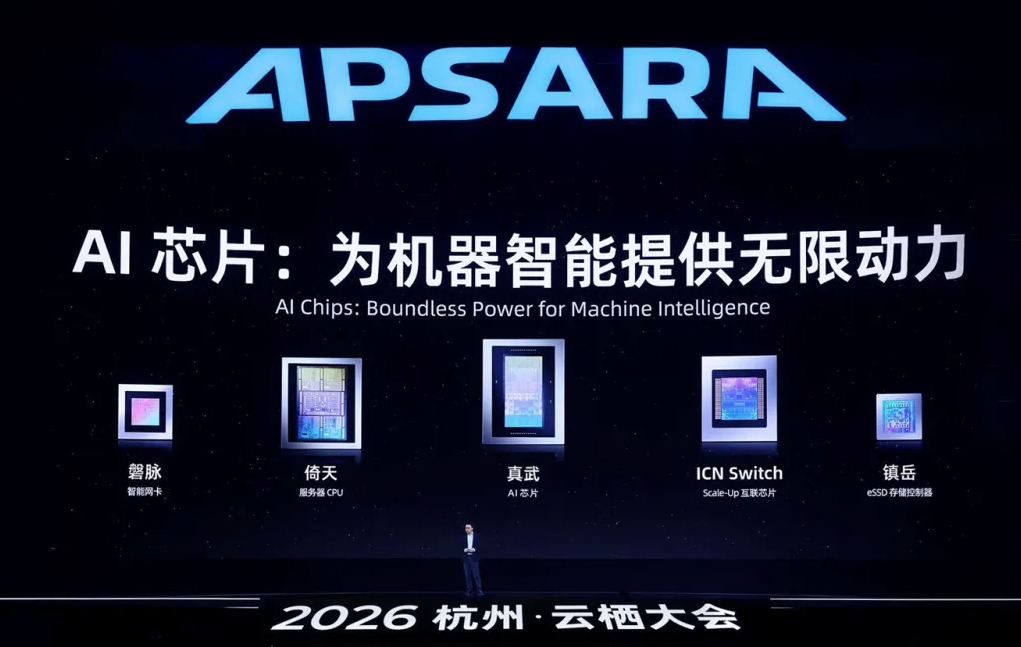
CPU 赛道同样在推进:2027 年推出倚天 720 与倚天 730,其中 730 首次采用全自研微架构,单核 SPECint 2017/GHz 性能最高可达倚天 710 的 1.4 倍;2029 年倚天 750 将通过 ICN 总线与真武芯片直接互联。至此,搭建超大规模 AI 集群所需的核心芯片已实现全面覆盖。
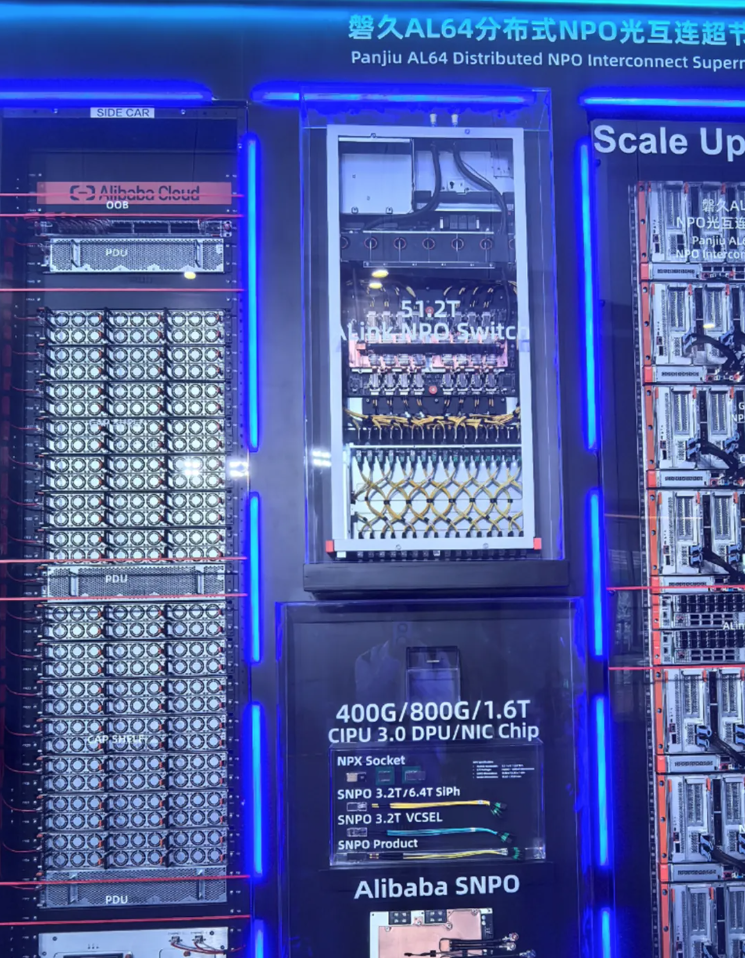

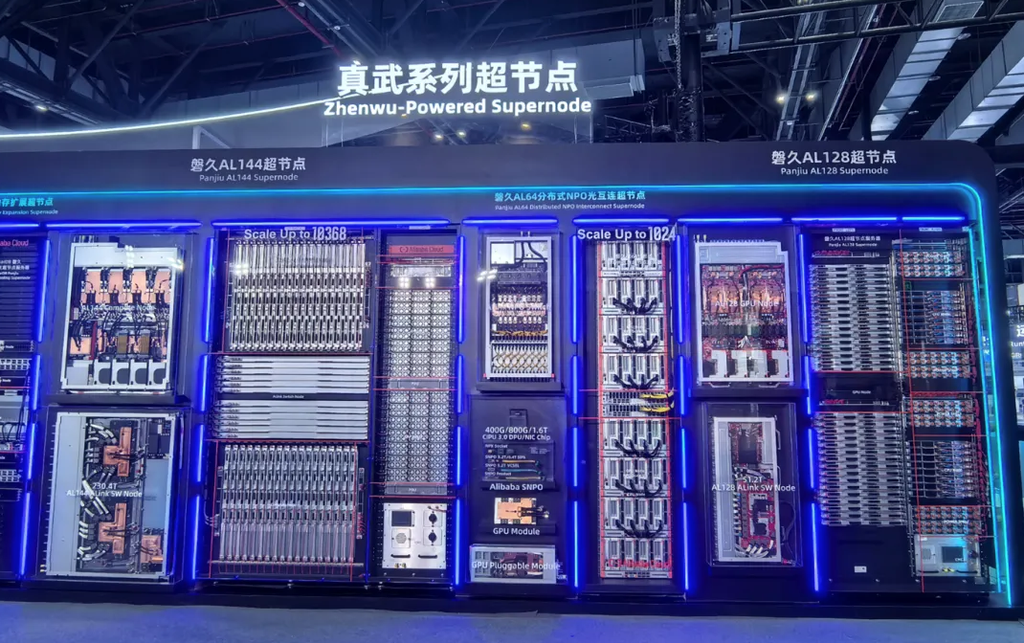
超节点的价值不在单卡,在于这堆线缆和交换机把 64 张卡变成一个整体。
云侧当前真正落地的是 GP9A。
灵骏真武M890 超节点实例 GP9A 已对外提供服务,是国内首个可稳定运行超 2 万亿参数大模型的超节点形态算力,目前已承载 Qwen3.8-Max 与 Kimi K3。规格方面:依托 ICN Switch 1.0 实现 64 张 M890 卡之间800GB/s 高速互联,显存池容量 9TB;在Agentic 推理场景下,最高可实现 1.5 倍性能提升。底层依托灵骏智算平台+HPN 8.0 训推一体网络,单集群最高支持 13 万卡异构算力混布,可弹性扩展至百万卡级。该实例首批在乌兰察布开服,中卫节点尚在规划中。
阿里云自己的定调是:”从能不能用,升级为可支撑前沿大模型、可投入生产环境的算力系统。
这句话我想单独拎出来。国产算力这两年最大的争议从来不是峰值参数,而是”能不能长期稳定跑在生产环境里”。GP9A 对外服务、承载两个 2 万亿级模型,是这个争议的第一个有分量的回答。
软件层的价值可以折算为成本改善指标:新一代全栈自研 CPFS 具备百 TB/s 级吞吐、亿级 IOPS,单文件系统规模提升 5 倍至100PiB;实际训练场景中,模型启动平均耗时降低 50%,峰值算力利用率提升 30%,AI 存储成本下降 69%。推理侧,Tair KVCM 使每 Token 成本下降 50%,KVCacheStore 将首Token 响应时延下降 54%。
供给节奏分两层:本季度开始已规模化上架 AI 超节点,2026 年第四季度还将新增服务节点。存量也在扩:截至 2026 年 6 月,真武系列已服务超过 650 家企业客户;截至2026年4月,平头哥真武 AI 芯片累计出货 56 万片。
吴泳铭也没有回避约束:客户 AI 需求十分强劲,阿里云收入持续加速增长,但行业中长期需求远超供给能力,AI 数据中心相关供应链的全球性紧缺正在制约算力扩张速度。目标是到 2032 年,阿里云运营的全球数据中心规模超过 20GW。
04 为什么我说 42% 才是今天最该记的数字
回到开头。
仅基于一份真实的芯片模块规范,Qwen3.8-Max 自主运行超过 60 小时、调用 EDA 工具超过万次,完成从功能架构设计、验证到物理实现的完整流程,实现物理面积下降42%。
模型开始参与设计支撑自己运行的那块芯片。
反方向也在发生:在平头哥自研的真武 M890 上,Qwen3.8-Max”从零适配”全新的 Qwen3.8-Flash-Next,交付了一套可运行的推理栈——长文本首 Token 延迟下降47%,每输出 Token 延迟下降 60%,日常对话场景单实例吞吐提升 96%。
这就是本次大会反复提到的 “协同飞轮”:模型与 Agent 的真实需求牵引芯片与系统设计,云平台将硬件能力封装为可规模化交付的服务,模型再反向优化推理软件与芯片设计。

我的看法是:单点性能是新闻,闭环才是护城河。
50 万卡是个能被追赶的数字,3 倍是个能被下一代覆盖的数字,但”模型自己设计芯片→芯片反过来加速模型”这个循环一旦转起来,追赶者要补的就不是一颗芯片,而是一整套反馈机制。这也是为什么全球同时具备自研芯片、大模型和 AI 云全栈能力的公司,一只手数得过来。
今年云栖大会的叙事重心,明显从 “模型有多强” 转向 “能否规模化交付”。GP9A 对外服务、Q4 扩容、20GW 目标,全部是供给侧关键词。当然最值得关注的不是发布会本身,而是第四季度的开服节奏。供应链紧缺已是明牌,谁能真正落地部署节点,谁才算兑现 PPT 里的承诺。
吴泳铭在主论坛结尾留下一句话:AI 越强大,人类越强大。
三块基石铺就了这条道路的底座。而底座向来不性感,却决定大楼能盖多高。
第一天硬数字速查
50 万卡|基于真武V900 的单一AI 集群扩展上限(芯片2027Q1 量产)
5-10T|Qwen4.5/Qwen5 计划扩展的参数规模(路线图;Qwen4 已投入训练)20GW|2032 年阿里云运营全球数据中心规模目标
42% Qwen3.8-Max 自主跑完芯片设计全流程实现的物理面积下降
3倍/216GB/1200GB/s|V900 性能倍数、显存、片间互联带宽
9TB/800GB/s|GP9A 超节点实例显存池、64 卡卡间互联
69%/50%/30%|CPFS 带来的 AI 存储成本降、模型启动耗时降、峰值算力利用率升
33 轮/+12.5%|RSI 零人工参与迭代轮数、Artificial Analysis 得分涨幅
650 家/56 万片|真武系列客户数(截至 6 月)、累计出货(截至 4 月)